
Dados sujos são registros duplicados, incompletos, desatualizados ou divergentes entre sistemas que podem comprometer análises, operações e decisões de negócio. Eles podem surgir em diferentes pontos da jornada do dado, desde a coleta e as integrações até a forma como as informações são armazenadas e utilizadas.
Na prática, o problema aparece quando um cliente é contatado na hora errada, uma campanha é direcionada para quem já converteu ou um relatório precisa de um “ajuste manual” antes de ser apresentado. Muitas vezes, não existe um erro evidente: o dado apenas deixou de representar corretamente o que aconteceu.
Neste guia, você vai entender o que caracteriza um dado sujo, quais são suas principais causas e como preveni-lo, com práticas de coleta, validação e governança que podem ser incorporadas à rotina da empresa.
O que caracteriza um dado sujo
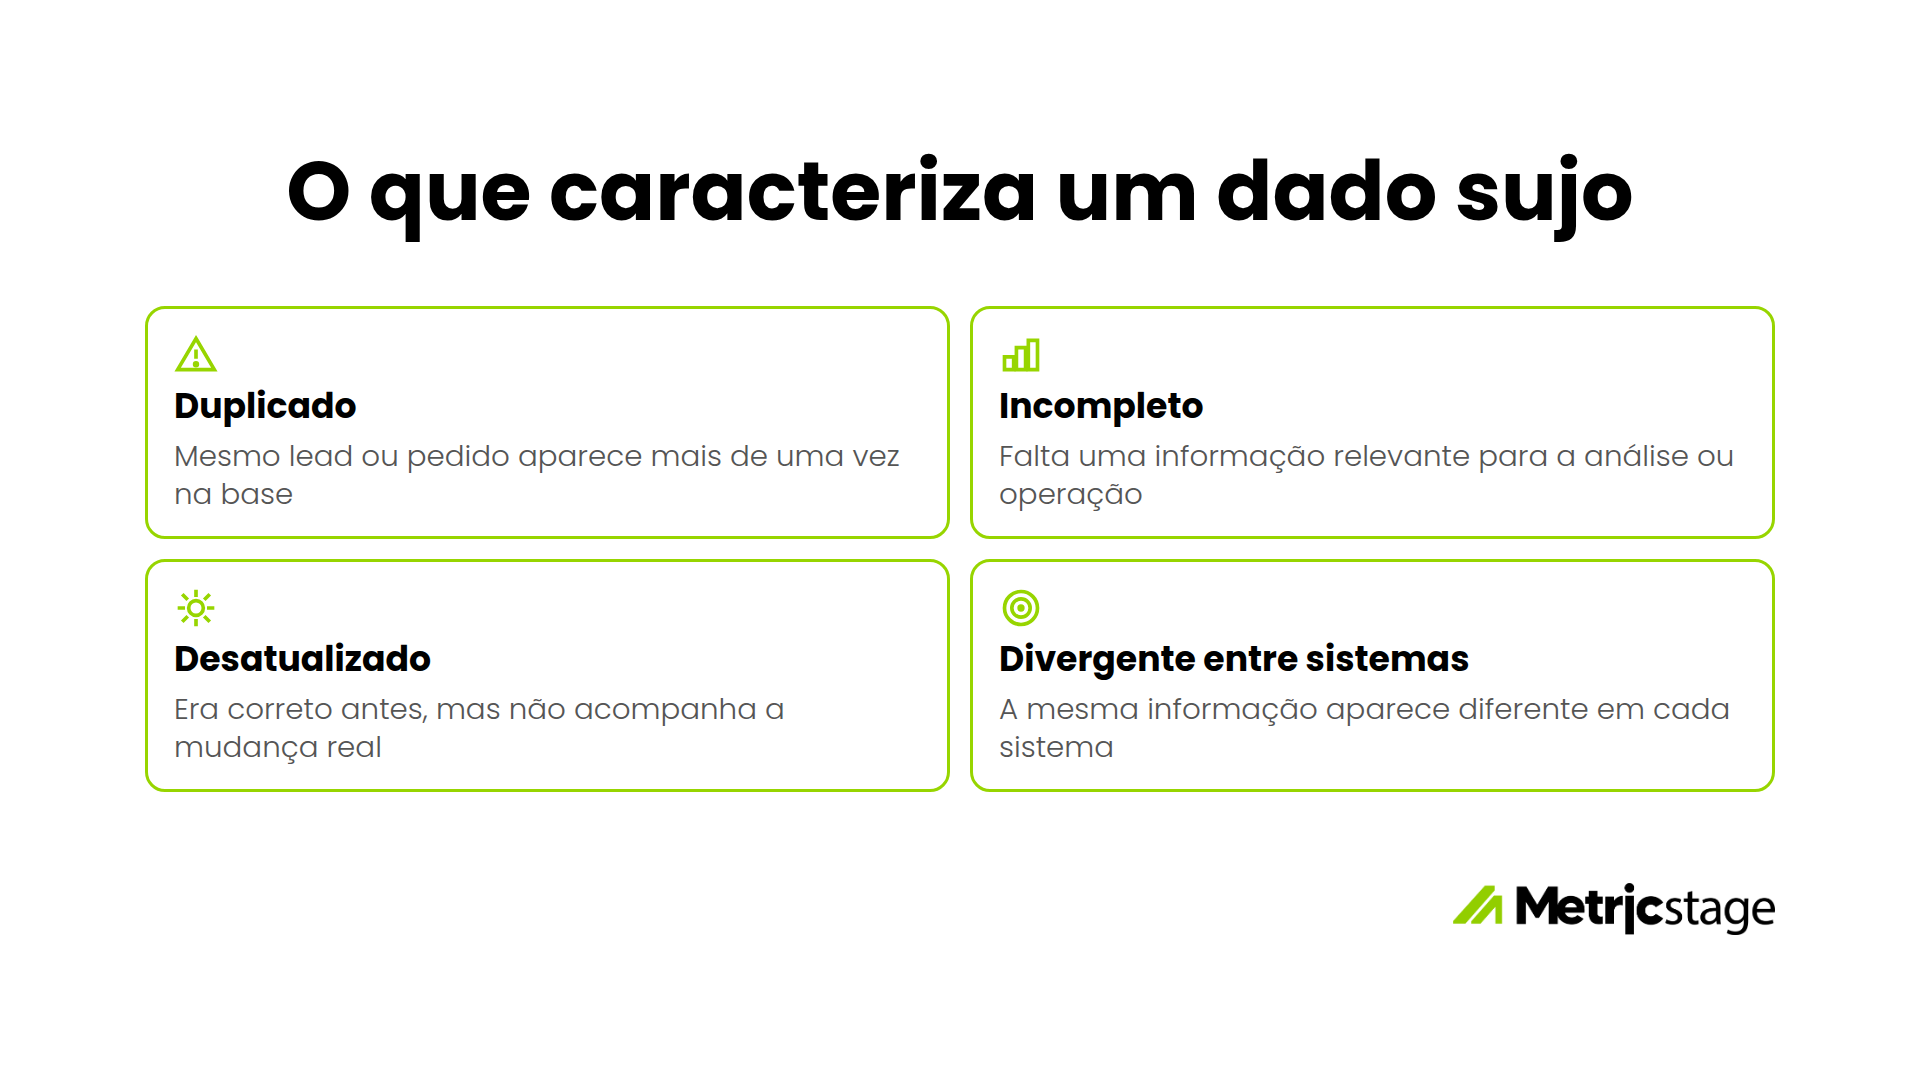
Um dado sujo não é necessariamente um dado “errado”. Ele pode até ter sido correto em algum momento, mas deixou de representar a realidade ou perdeu informações importantes para sua utilização. No dia a dia, os problemas mais comuns podem ser agrupados em quatro características:
Duplicado: o mesmo lead, cliente ou pedido aparece mais de uma vez na base, seja por entrada em diferentes canais, reenvio de formulário ou falha em uma integração;
Incompleto: falta uma informação relevante para a análise ou operação, como a origem de tráfego de um lead, o vendedor responsável por uma oportunidade ou a forma de pagamento de um pedido;
Desatualizado: o registro já foi correto, mas não acompanha uma mudança na realidade. É o caso de um contrato que aparece como “em negociação” mesmo depois de ter sido fechado ou cancelado;
Divergente entre sistemas: a mesma informação aparece de formas diferentes em sistemas distintos. Uma venda, por exemplo, pode ter valor ou data diferentes no CRM, no financeiro e no dashboard de marketing quando não existem regras comuns de atualização e reconciliação.
Essas quatro características são, na prática, o reverso dos critérios que definem qualidade de dados, se quiser aprofundar o conceito, veja em Qualidade de dados: o que é e como garantir na prática.
De onde vêm os dados sujos, na maioria dos casos
O ponto de origem mais comum é o tracking mal configurado. Quando um evento de conversão dispara errado, duplicado ou fora do contexto certo no GA4 ou no Google Tag Manager, o dado já nasce sujo, antes mesmo de chegar a qualquer relatório ou dashboard.
O segundo ponto comum é integração quebrada entre sistemas. Um CRM que para de sincronizar com a ferramenta de e-mail marketing, um webhook que falha silenciosamente e deixa de atualizar o status de um pedido, uma API que muda de formato sem aviso, tudo isso gera lacunas e divergências que só aparecem quando alguém já está usando o dado para decidir.
O terceiro é a ausência de padronização de nomenclatura. Quando cada área nomeia campanha, canal ou etapa do funil do próprio jeito, "Google Ads" numa planilha e "google_ads" em outra, por exemplo, cruzar essas informações depois vira um trabalho manual sujeito a erro.
O quarto é a digitação manual em planilhas paralelas. Toda vez que um dado precisa ser copiado à mão de um sistema para outro, existe uma chance de erro de digitação, de desatualização e de uma versão da verdade que só uma pessoa conhece.
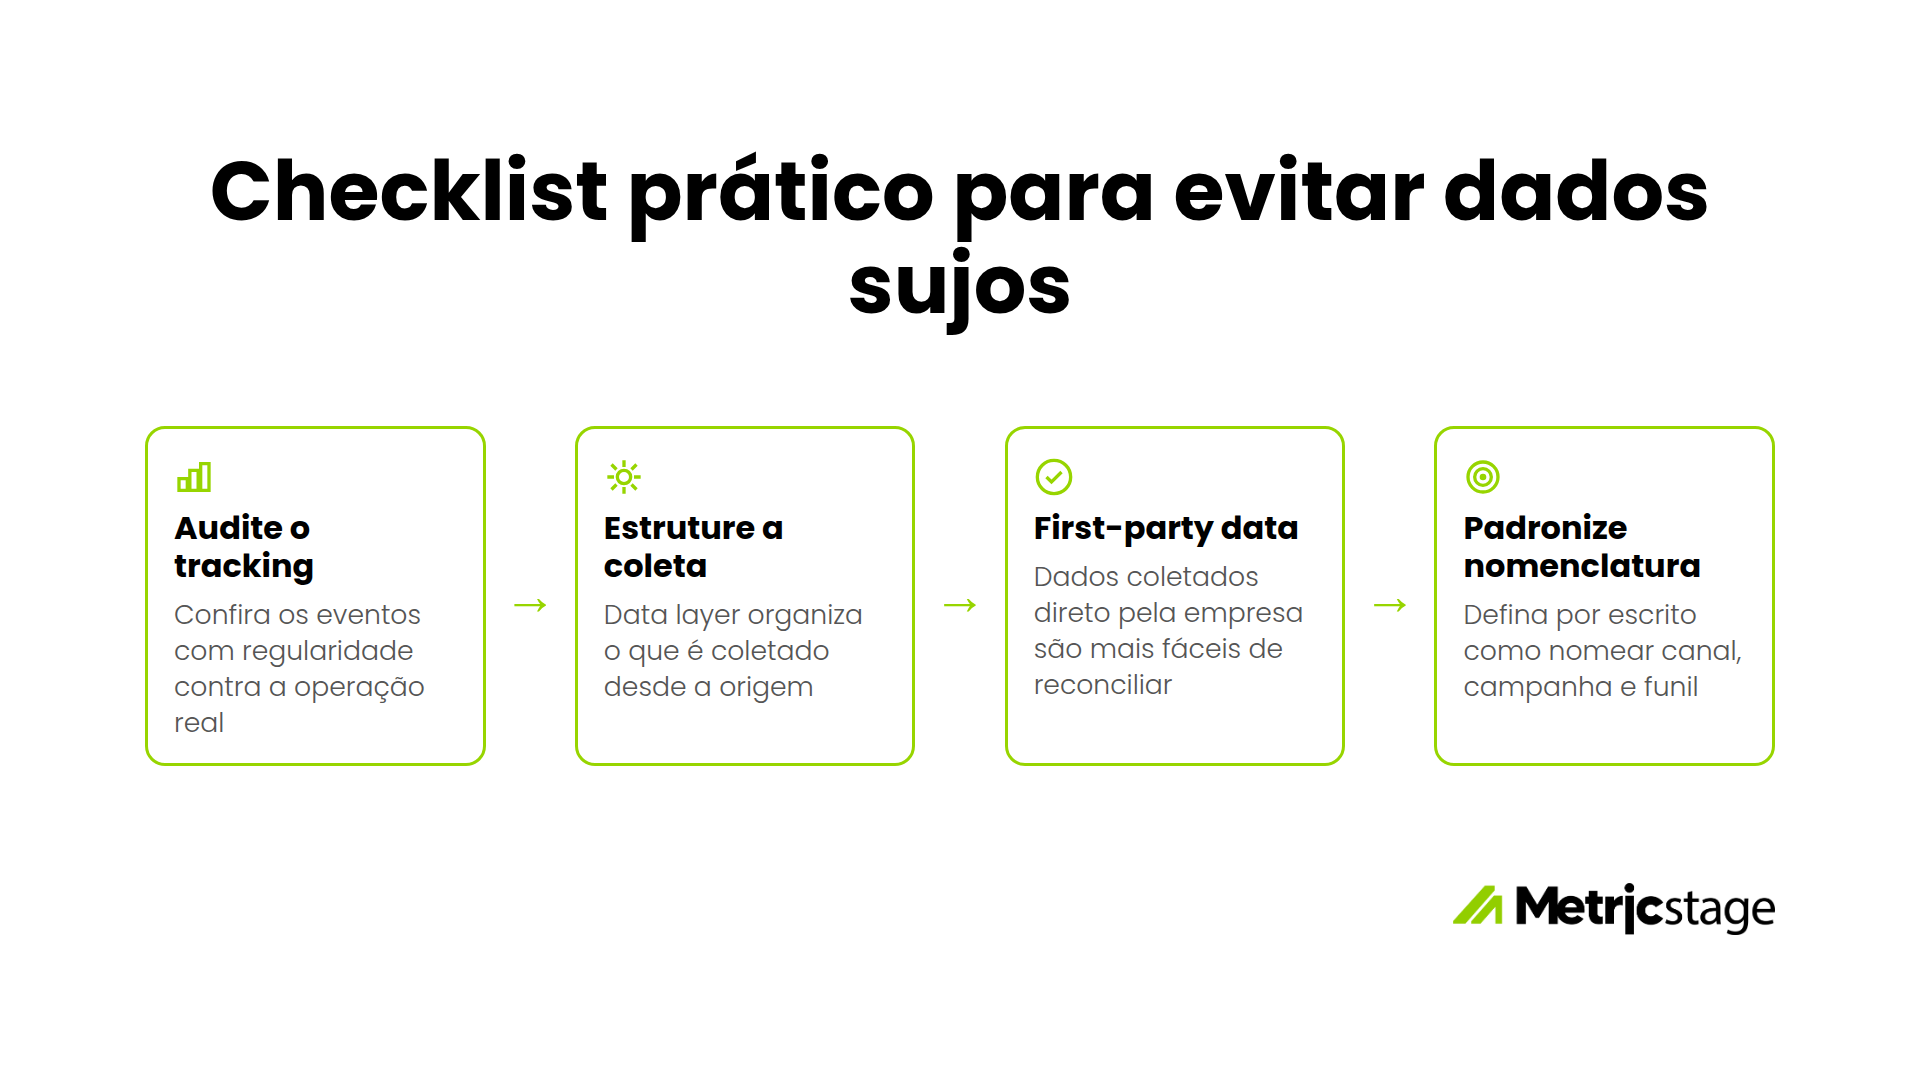
Checklist prático: cinco passos para evitar dados sujos
Evitar dados sujos exige olhar para diferentes pontos da jornada da informação, desde a coleta até a forma como ela é organizada e utilizada. As práticas abaixo ajudam a identificar problemas antes que eles cheguem aos relatórios e às decisões de negócio.
1. Audite o tracking periodicamente
Configuração de GA4 e Google Tag Manager não é algo que se implementa uma vez e esquece. Eventos de conversão precisam ser checados com regularidade contra o que realmente acontece na operação, porque uma nova página, um novo formulário ou uma mudança no site pode quebrar um evento sem que ninguém perceba.
2. Estruture a coleta na origem
Grande parte do dado sujo nasce porque a coleta não segue um padrão. Uma camada de dados (data layer) bem estruturada organiza o que é coletado antes mesmo de o evento chegar em qualquer ferramenta de análise, reduzindo drasticamente o retrabalho de limpeza depois.
3. Priorize first-party data como base de coleta
Dados coletados diretamente pela própria empresa, no próprio site, aplicativo ou CRM, tendem a ser mais completos e mais fáceis de reconciliar do que dados vindos de fontes de terceiros. Tratar o first-party data como um ativo estratégico reduz a dependência de integrações frágeis com plataformas externas.
4. Reduza perda de dados com server-side tagging
Bloqueadores de anúncio, restrições de navegador e falhas de conexão no lado do cliente derrubam parte significativa dos eventos disparados no navegador do usuário. Server-side tagging move parte desse processamento para um ambiente controlado pela própria empresa, reduzindo a perda e a distorção de dados antes que eles cheguem à base.
5. Padronize nomenclatura entre áreas
Defina, por escrito, como cada canal, campanha e etapa de funil deve ser nomeada, e aplique essa convenção em todos os sistemas que alimentam relatórios importantes. Isso parece pequeno, mas é o que evita boa parte do trabalho manual de reconciliar planilhas depois.
Planilha paralela: sintoma e risco
Quando um número não bate, uma resposta comum é criar uma planilha à parte para “corrigir” o dado manualmente antes da próxima reunião. Isso resolve o problema daquele momento, mas cria outro: uma segunda fonte de informação que não foi formalizada, mantida por alguém que conhece um ajuste que nunca foi documentado.
O risco aparece em dois cenários. Se essa pessoa muda de time ou sai da empresa, o conhecimento sobre o ajuste pode desaparecer com ela, deixando a planilha desatualizada sem que ninguém perceba. Além disso, a planilha pode passar a concentrar informações sensíveis, como dados de clientes, valores de contratos e condições comerciais, fora dos controles de acesso e governança dos sistemas oficiais.
A planilha paralela é um sintoma de dado sujo, não uma solução. Enquanto ela for necessária para corrigir os números antes de uma decisão, a causa do problema continua sem ser resolvida.
Como validar continuamente, não só uma vez
Evitar dados sujos não termina depois de uma correção. A qualidade precisa ser acompanhada ao longo do tempo, principalmente nos dados que alimentam decisões importantes. Algumas práticas ajudam a identificar desvios antes que eles cheguem aos relatórios:
Data profiling: análise periódica da base para identificar duplicidades, campos vazios, valores fora do padrão e mudanças inesperadas na distribuição dos dados.
Validação cruzada: comparação de uma informação importante com sua fonte de origem ou com outro sistema de referência, como CRM e financeiro, para identificar divergências.
Alertas automáticos: notificações quando um indicador foge de um comportamento esperado, como uma queda abrupta no volume de eventos ou um campo que passa a chegar vazio.
Rotina leve de governança
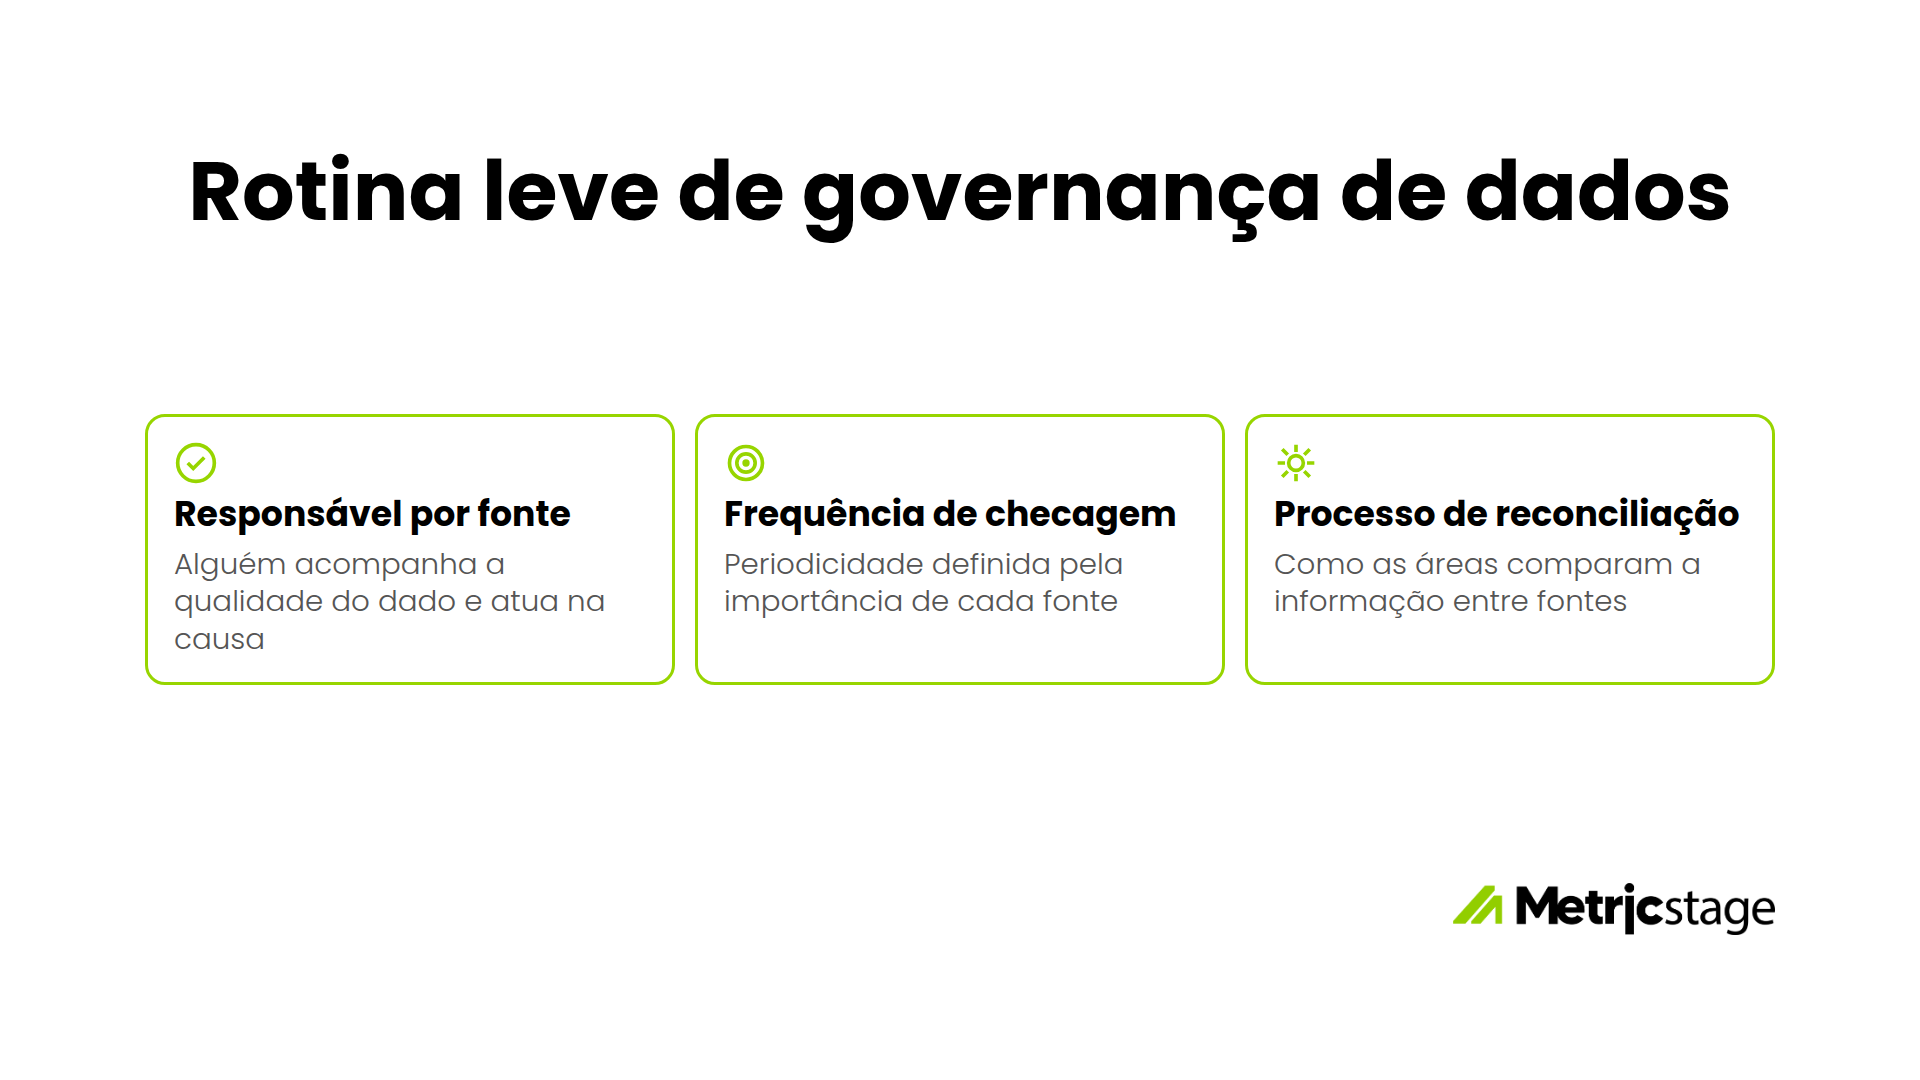
Essas práticas precisam estar associadas a responsabilidades claras. Isso não significa criar uma estrutura complexa de governança, mas definir quem acompanha os dados, com que frequência e o que acontece quando uma divergência é identificada.
Responsável por cada fonte crítica: alguém precisa acompanhar a qualidade do dado e atuar sobre a causa quando surgir uma inconsistência;
Frequência de checagem: defina uma periodicidade de acordo com a importância da fonte, em vez de depender de alguém perceber que “parece que algo está errado”;
Processo de reconciliação: estabeleça como marketing, comercial e financeiro devem comparar informações quando um mesmo indicador depende de mais de uma fonte.
Esse é o núcleo do que evita que marketing, comercial e financeiro cheguem a métricas diferentes para o mesmo indicador, assunto que a gente aprofunda em Governança de dados: como evitar métricas diferentes.
Dado sujo não se resolve limpando uma planilha uma vez, se resolve corrigindo a origem: o tracking que dispara errado, a integração que falha silenciosamente, o padrão de nomenclatura que nunca foi definido, a ausência de alguém responsável por perceber quando algo começa a divergir.
O checklist deste guia ajuda a prevenir a maior parte dos casos, mas empresas que já acumularam anos de planilha paralela e retrabalho manual geralmente precisam de um pente-fino mais profundo para encontrar todas as causas ao mesmo tempo.
É exatamente esse o trabalho do Setup & Auditoria da Metricstage: mapear onde o dado está nascendo sujo, da coleta à reconciliação entre sistemas, e estruturar a base antes de qualquer novo dashboard ser construído em cima dela.
Começamos pela pergunta que você precisa responder — e pela qualidade dos dados que sustentam essa resposta.